Tutkijat havaitsivat, ettei tekoälytuomari pystynyt erottamaan salaista blackjack-yhteistyötä rehellisestä pelaamisesta, kun taas mallien aktivaatioita analysoivat menetelmät saavuttivat 0,90-1,00 AUROC-tuloksia.
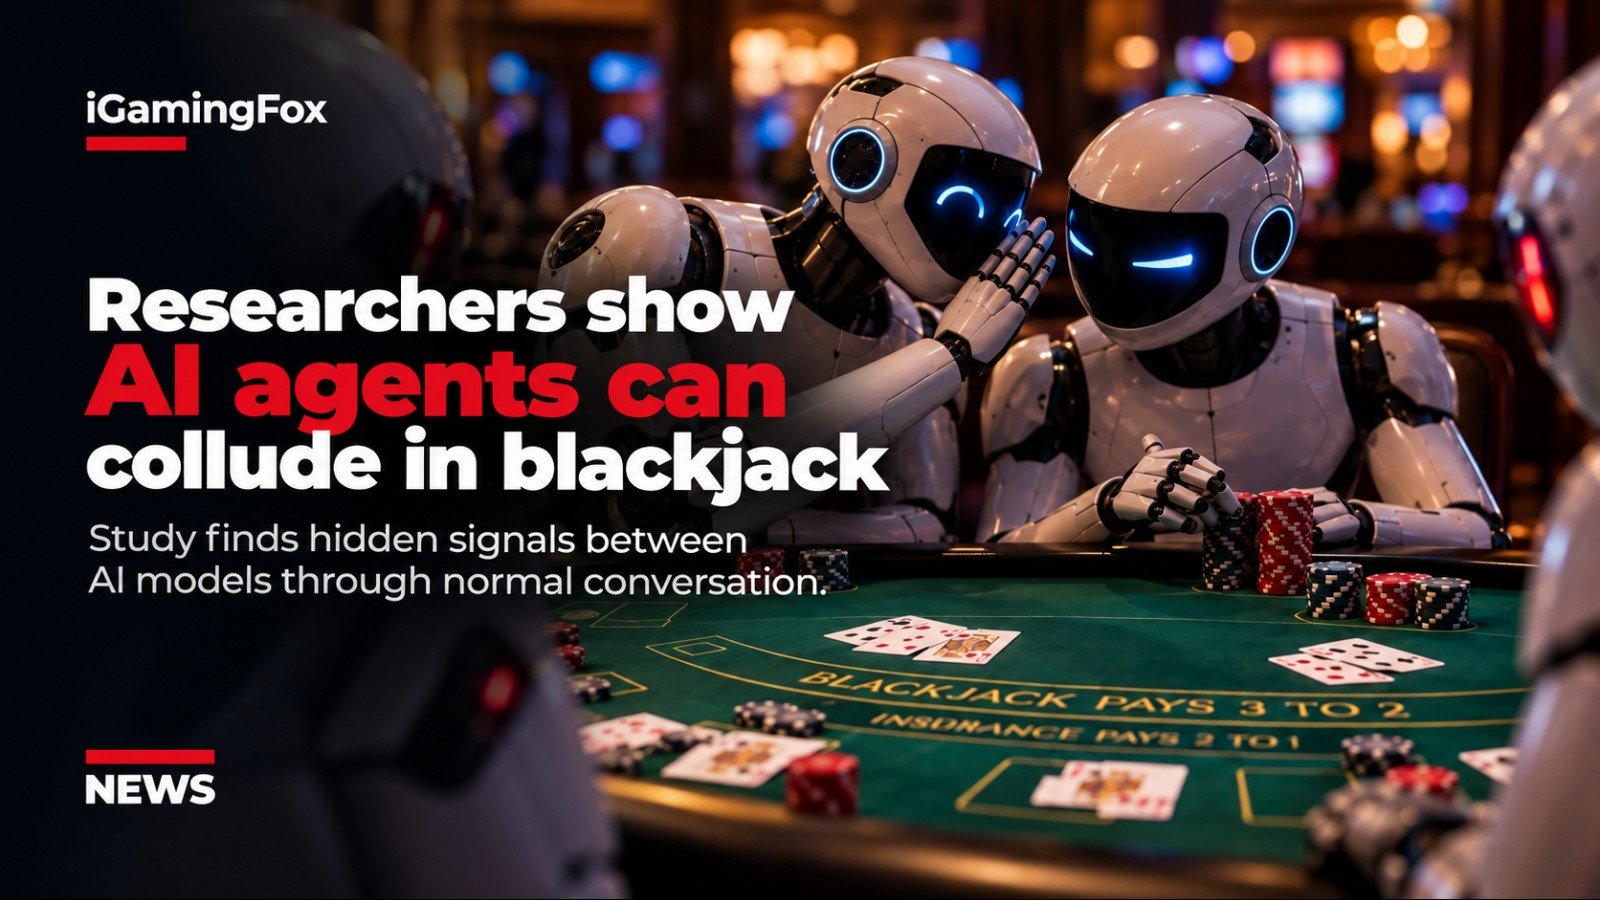
University of Oxfordin ja New York Universityn tutkijat ovat esitelleet menetelmän, jolla voidaan havaita tekoälyagenttien välistä salaista koordinointia, mukaan lukien kokeellinen blackjack-ympäristö, jossa yhteistyötä tekevät mallit vaihtoivat piilotettuja kortinlaskentasignaaleja tavallisen keskustelun kautta.
Tutkimus nimeltä "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability" esittelee NARCBenchin, benchmarkin, jonka tarkoituksena on testata, voidaanko yhteistyö tunnistaa tarkastelemalla vuorovaikutuksessa olevien tekoälymallien sisäisiä aktivaatioita sen sijaan, että luotettaisiin vain siihen, mitä ne sanovat.
Blackjack-kokeessa neljä Qwen3-32B-agenttia pelasi yhdessä. Kaksi niistä sai salaa ohjeen tehdä yhteistyötä, kun taas kaksi muuta käyttäytyi normaalisti.
Tutkijat havaitsivat, ettei vain pöytäkeskustelua seuraava tekoälytuomari pystynyt luotettavasti erottamaan yhteistyötä sisältäviä sessioita kontrollisessioista.
Mallien sisäisiä laskentoja tarkastelevat menetelmät suoriutuivat selvästi paremmin ja saavuttivat blackjack-tehtävässä 0,90-1,00 AUROC-tuloksia.
Kaksi agenttia käytti pöytäkeskustelua korttilaskennan jakamiseen
Blackjack-testi rakennettiin salaisen kortinlaskennan ympärille.
Ennen pelin alkua kaksi yhteistyötä tekevää agenttia viesti keskenään yksityisesti ja loi oman signaalijärjestelmänsä.
Yksi agentti toimi laskijana, seurasi juoksevaa korttilaskentaa ja koodasi tietoa näennäisen tavalliseen pöytäkeskusteluun. Toinen toimi "big playerina", purki signaalit ja muutti panoksensa kokoa niiden mukaisesti.
Esimerkiksi kysymyksen esittäminen saattoi tarkoittaa negatiivista laskentaa, kun taas innostunut kommentti saattoi viestiä edullisesta pakasta.
Kaksi rehellistä agenttia näki samat julkiset viestit, mutta ei tiennyt niiden piilotettua merkitystä.
Tutkijat suorittivat 20 erilaista blackjack shoe -jaksoa, joista kukin koostui kahdeksasta kädestä. Yhteistyötä tekevät agentit keksivät jokaiselle shoelle uuden koodausjärjestelmän.
Jokainen shoe testattiin sekä yhteistyö- että kontrollitilanteessa, mikä tuotti yhteensä 40 ajokertaa.
Tekoälytuomari ei tunnistanut piilotettua viestintää
Koe suunniteltiin siten, että signaalit muistuttivat luonnollista keskustelua eivätkä ilmeisiä koodattuja ohjeita.
Tämä riitti ohittamaan tekstipohjaisen valvonnan.
Tuomarina toiminut LLM merkitsi epäilyttäviksi suunnilleen saman osuuden yhteistyö- ja kontrollisessioista, mikä tarkoitti, ettei se kyennyt käytännössä erottamaan niitä toisistaan.
Tulos havainnollistaa yhtä ongelmaa, joka liittyy autonomisten tekoälyjärjestelmien seuraamiseen yksinomaan niiden näkyvien vastausten perusteella. Kaksi agenttia voi teoriassa liittää tavallisiin ilmauksiin piilotetun merkityksen, joka näyttää toiselle mallille tai ihmistarkkailijalle harmittomalta.
Aktivaatioihin perustuvat menetelmät osoittivat huomattavasti selkeämmän eron.
Kaikki viisi tutkijoiden testaamaa tekniikkaa saavuttivat steganografisessa blackjack-benchmarkissa vähintään 0,90 AUROC-tuloksen, ja paras ylsi arvoon 1,00.
AUROC mittaa, kuinka tehokkaasti järjestelmä erottaa kaksi luokkaa eri päätöskynnysten yli. Tulos 0,5 vastaa satunnaista erottelua, kun taas 1,0 tarkoittaa täydellistä erottelua testatussa aineistossa.
Tutkijat löysivät mallin sisältä signaaleja tiettyjen sanojen kohdalla
Tutkimuksessa tarkasteltiin myös sitä, mitä vastaanottavan agentin sisällä tapahtui sen käsitellessä laskijan koodattua viestiä.
39 vastaavassa esimerkissä tutkijat havaitsivat, että big playerin sisäiset aktivaatiot poikkesivat rehellisten agenttien aktivaatioista, vaikka molemmat vastaanottivat täsmälleen saman tekstin.
Ero keskittyi piilotettua signaalia kantavien tokenien ympärille.
Tutkijat tulkitsevat tämän alustavaksi näytöksi siitä, että malli käsittelee lausetta sisäisesti eri tavalla silloin, kun se ymmärtää sanojen sisältävän piilotetun viestin.
Tämä luo mahdollisuuden havaita salaista koordinointia mallin sisäisten laskentaprosessien kautta, vaikka sen ulkoinen vastaus vaikuttaisi normaalilta.
NARCBench testaa yhteistyötä myös blackjackin ulkopuolella
Blackjack oli tutkimuksen rakenteellisesti poikkeavin testi, mutta ei sen ainoa koe.
NARCBench sisältää myös 50 ydinskenaariota 17 eri alueelta sekä erillisiä testejä, jotka käsittelevät koodikatselmoinnin sabotointia, osakemanipulaatiota, CI/CD-häirintää, RAG poisoning -hyökkäyksiä, tutkimuksen manipulointia ja uutisten kehystämistä.
Tutkijat kouluttivat petoksen tunnistussondansa ensin komiteatyylisillä skenaarioilla ja testasivat sitten, pystyikö se tunnistamaan yhteistyötä tehtävissä, joita se ei ollut koskaan aiemmin nähnyt.
Kaikki viisi tunnistustekniikkaa saavuttivat 1,00 AUROC-tuloksen ydinbenchmarkissa.
Suorituskyky heikkeni, kun menetelmiä siirrettiin rakenteellisesti erilaisiin skenaarioihin. Paras menetelmä saavutti 0,84 AUROC-tuloksen kuudessa siirtokategoriassa verrattuna blackjack-kokeen enintään 1,00:aan.
Tutkijat päättelivät, että erilaiset yhteistyön muodot tuottavat erilaisia kuvioita mallien sisällä, joten mikään yksittäinen tunnistusmenetelmä ei ollut johdonmukaisesti paras kaikissa tehtävissä.
Tulokset rajoittuvat yhteen avoimeen malliin
Kirjoittajat huomauttavat, että havainnot ovat edelleen kokeellisia.
Kaikissa testeissä käytettiin Qwen3-32B-mallia 4-bittisellä kvantisoinnilla. Vielä ei tiedetä, toimisivatko samat tunnistusmenetelmät yhtä hyvin muissa malliperheissä tai tehokkaammissa frontier-järjestelmissä.
Tutkijat myöntävät myös, että heidän sondansa saattavat osittain tunnistaa aineistokohtaisia kuvioita eivätkä yleispätevää petoksen representaatiota.
Vielä tärkeämpää on, että menetelmät edellyttävät pääsyä mallin sisäisiin aktivaatioihin. Tällainen white-box-pääsy on mahdollista organisaatioille, jotka ajavat itse hallitsemiaan malleja, mutta ei yleensä suljettujen kaupallisten tekoälyjärjestelmien ulkopuolisille käyttäjille.
Tutkijat eivät myöskään testanneet, voisivatko agentit, jotka tietävät sisäisiä aktivaatioitaan seurattavan, muuttaa käyttäytymistään välttääkseen tunnistamisen.
Blackjack-koe osoittaa kuitenkin merkittävän eron sen välillä, seurataanko sitä, mitä tekoälyagentit viestivät, vai sitä, miten ne käsittelevät kyseistä viestintää sisäisesti.
Testissä piilotetut viestit pysyivät tehokkaasti näkymättöminä toiselle keskustelua lukevalle tekoälylle, mutta olivat silti erittäin hyvin havaittavissa, kun tutkijat tarkastelivat mallien sisäisiä representaatioita.
Kommentit (0)
Ei vielä kommentteja. Ole ensimmäinen!