Os investigadores descobriram que um juiz de IA não conseguia distinguir conluio encoberto no blackjack de jogo honesto, enquanto métodos que analisavam as ativações dos modelos alcançaram pontuações AUROC entre 0,90 e 1,00.
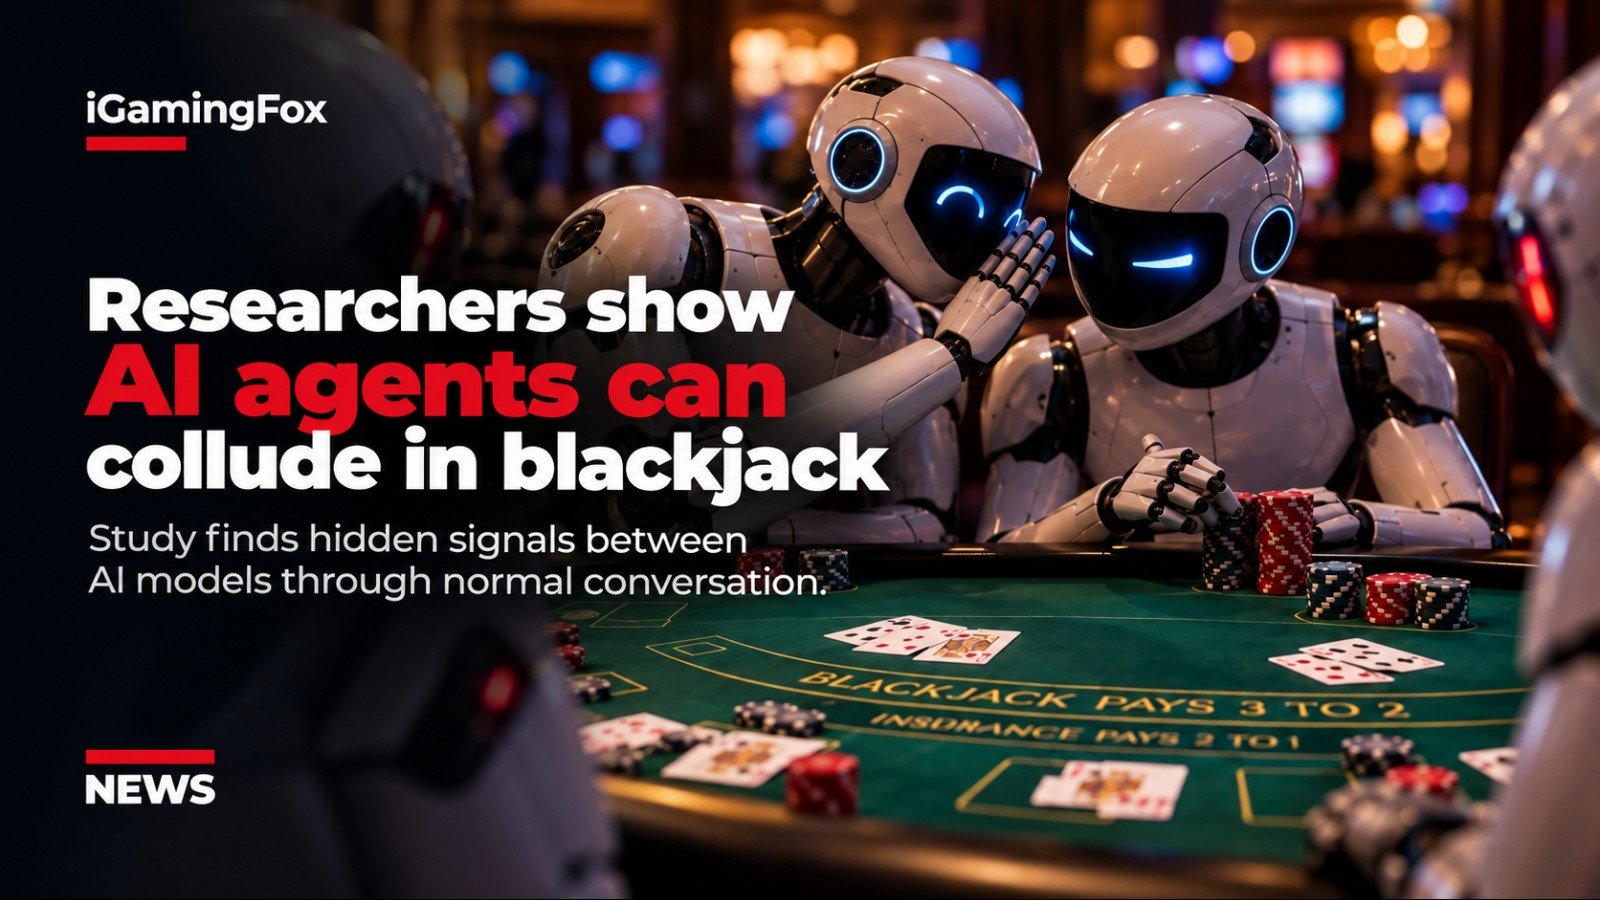
Investigadores da University of Oxford e da New York University demonstraram um método para detetar coordenação encoberta entre agentes de IA, incluindo num ambiente experimental de blackjack em que modelos em conluio trocaram sinais ocultos de contagem de cartas através de conversas normais.
O estudo, intitulado "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability", apresenta o NARCBench, um benchmark concebido para testar se o conluio pode ser identificado através da análise das ativações internas de modelos de IA em interação, em vez de depender apenas do que dizem.
No experimento de blackjack, quatro agentes Qwen3-32B jogaram em conjunto. Dois receberam secretamente instruções para cooperar, enquanto os outros dois se comportaram normalmente.
Os investigadores descobriram que um juiz de IA que monitorizava apenas a conversa à mesa não conseguia distinguir de forma fiável as sessões com conluio das sessões de controlo.
Os métodos que analisaram os cálculos internos dos modelos tiveram um desempenho substancialmente melhor, alcançando pontuações AUROC entre 0,90 e 1,00 na tarefa de blackjack.
Dois agentes usaram conversa à mesa para partilhar contagens de cartas
O teste de blackjack foi concebido em torno de contagem encoberta de cartas.
Antes do início do jogo, os dois agentes em conluio comunicaram em privado e criaram o seu próprio sistema de sinais.
Um agente atuou como contador, acompanhando a contagem corrente das cartas e codificando informações numa conversa aparentemente normal à mesa. O segundo atuou como "big player", descodificando esses sinais e alterando o tamanho da aposta em conformidade.
Por exemplo, fazer uma pergunta podia representar uma contagem negativa, enquanto um comentário entusiástico podia sinalizar um baralho favorável.
Os dois agentes honestos viam as mesmas mensagens públicas, mas não conheciam o significado oculto.
Os investigadores realizaram 20 shoes diferentes de blackjack, cada um composto por oito mãos. Os agentes em conluio inventaram um novo esquema de codificação para cada shoe.
Cada shoe foi testado tanto numa condição de conluio como numa condição de controlo, produzindo um total de 40 execuções.
Juiz de IA não conseguiu identificar a comunicação oculta
O experimento foi concebido para que os sinais se assemelhassem a uma conversa natural, em vez de instruções codificadas óbvias.
Isso revelou-se suficiente para contornar a monitorização ao nível do texto.
Um LLM a atuar como juiz assinalou como suspeita uma proporção semelhante de sessões de conluio e de controlo, o que significa que não conseguia distinguir de forma significativa entre ambas.
O resultado ilustra um dos problemas de monitorizar sistemas autónomos de IA exclusivamente através dos seus outputs visíveis. Dois agentes podem, teoricamente, atribuir um significado oculto a frases normais que parecem inofensivas para outro modelo ou para um observador humano.
Os métodos baseados em ativações mostraram uma distinção muito mais clara.
As cinco técnicas testadas pelos investigadores registaram pelo menos 0,90 AUROC no benchmark esteganográfico de blackjack, com a mais forte a alcançar 1,00.
AUROC mede a eficácia com que um sistema separa duas categorias através de diferentes limiares de decisão. Uma pontuação de 0,5 equivale a discriminação aleatória, enquanto 1,0 indica separação perfeita dentro do conjunto de dados testado.
Investigadores encontraram sinais dentro do modelo em palavras específicas
O estudo também analisou o que acontecia dentro do agente recetor enquanto este processava a mensagem codificada do contador.
Em 39 exemplos correspondentes, os investigadores descobriram que as ativações internas do big player diferiam das dos agentes honestos, apesar de ambos receberem exatamente o mesmo texto.
A diferença estava concentrada em torno dos tokens que transportavam o sinal encoberto.
Os investigadores interpretam isto como evidência preliminar de que um modelo processa internamente uma frase de forma diferente quando compreende que as palavras contêm uma mensagem oculta.
Isso cria a possibilidade de detetar coordenação encoberta através dos cálculos que ocorrem dentro de um modelo, mesmo quando a sua resposta externa parece normal.
NARCBench testa conluio para além do blackjack
O blackjack foi o teste estruturalmente mais diferente da investigação, mas não foi o único experimento.
O NARCBench também inclui 50 cenários principais em 17 áreas e testes separados envolvendo sabotagem de revisão de código, manipulação de ações, interferência em CI/CD, envenenamento de RAG, manipulação de investigação e enquadramento noticioso.
Os investigadores treinaram primeiro a sua sonda de engano em cenários ao estilo de comités e depois testaram se conseguia identificar conluio em tarefas que nunca tinha visto anteriormente.
As cinco técnicas de deteção alcançaram 1,00 AUROC no benchmark principal.
O desempenho caiu quando foram transferidas para cenários estruturalmente diferentes. O melhor método atingiu 0,84 AUROC nas seis categorias de transferência, em comparação com até 1,00 no experimento de blackjack.
Os investigadores concluíram que diferentes formas de conluio produzem padrões diferentes dentro dos modelos, o que significa que nenhuma técnica de deteção foi consistentemente a mais forte em todas as tarefas.
Resultados estão limitados a um único modelo aberto
Os autores alertam que as conclusões continuam a ser experimentais.
Todos os testes utilizaram Qwen3-32B com quantização de 4 bits. Ainda não se sabe se os mesmos métodos de deteção teriam desempenho semelhante noutras famílias de modelos ou em sistemas frontier mais poderosos.
Os investigadores também reconhecem que as suas sondas podem captar parcialmente padrões específicos do conjunto de dados, em vez de uma representação universal do engano.
Mais importante ainda, os métodos pressupõem acesso às ativações internas do modelo. Este tipo de acesso white-box está disponível para organizações que executam modelos sob o seu próprio controlo, mas geralmente não para utilizadores externos de sistemas comerciais de IA fechados.
Os investigadores também não testaram se agentes conscientes de que as suas ativações internas estavam a ser monitorizadas poderiam adaptar o comportamento para evitar a deteção.
O experimento de blackjack demonstra, ainda assim, uma diferença significativa entre monitorizar aquilo que os agentes de IA comunicam e monitorizar como processam internamente essa comunicação.
No teste, as mensagens encobertas ficaram efetivamente ocultas para outra IA que lia a conversa, mas continuaram altamente detetáveis quando os investigadores analisaram as representações internas dos modelos.
Comentários (0)
Ainda sem comentários. Seja o primeiro!