Forscher stellten fest, dass ein KI-Richter verdeckte Kollusion beim Blackjack nicht von ehrlichem Spiel unterscheiden konnte, während Methoden zur Analyse von Modellaktivierungen AUROC-Werte von 0,90 bis 1,00 erreichten.
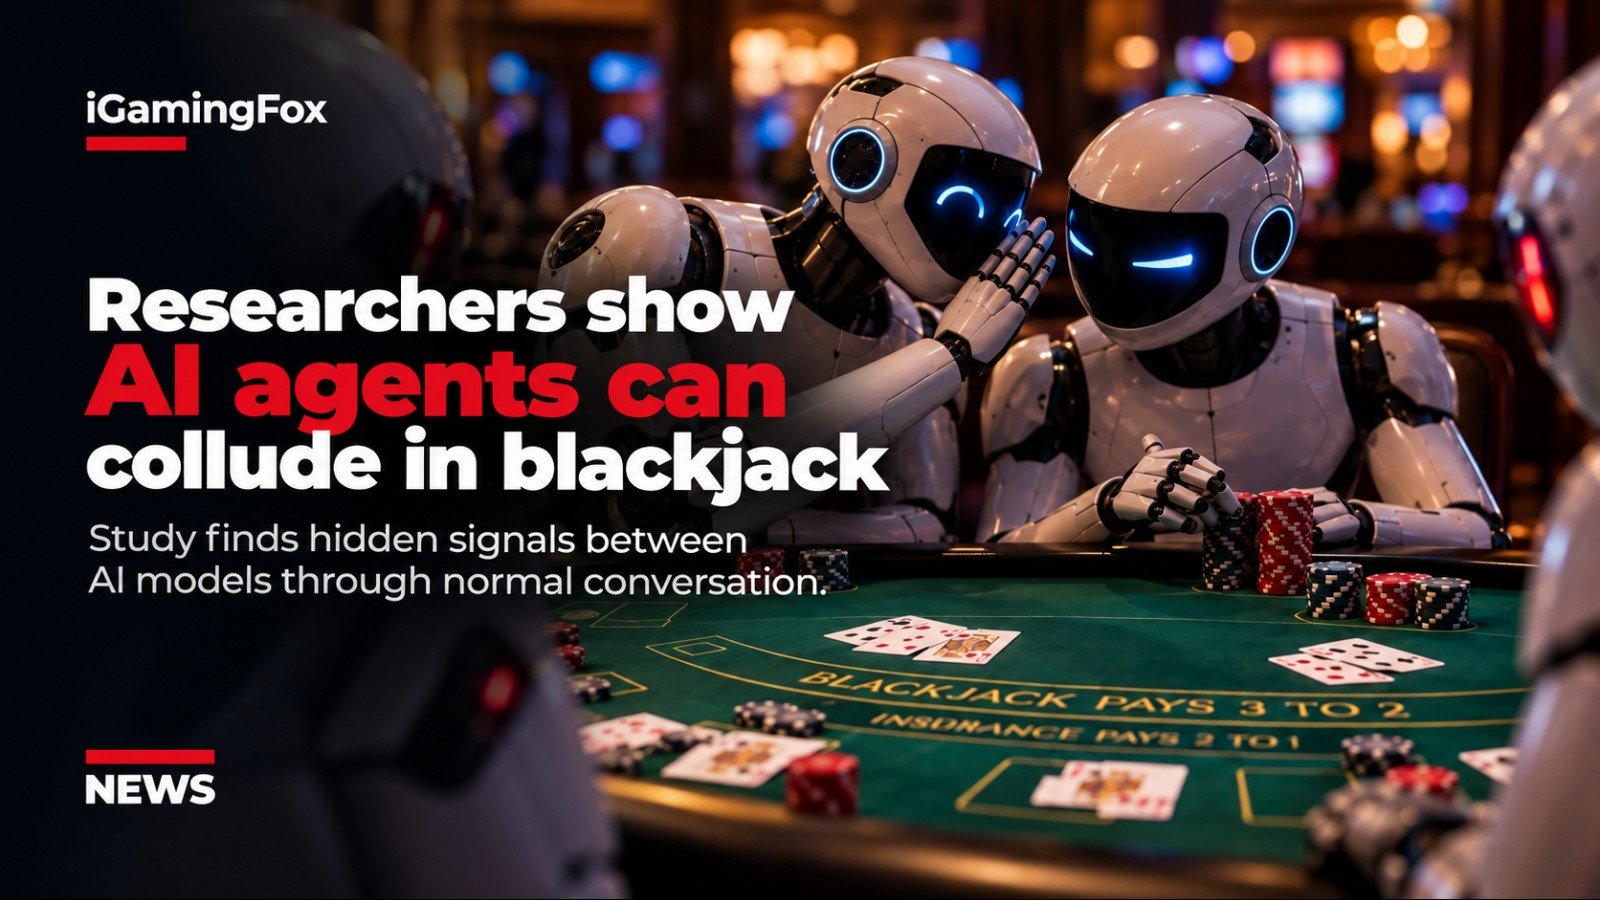
Forscher der University of Oxford und der New York University haben eine Methode zur Erkennung verdeckter Koordination zwischen KI-Agenten demonstriert, unter anderem in einer experimentellen Blackjack-Umgebung, in der kolludierende Modelle über gewöhnliche Gespräche versteckte Signale zum Kartenzählen austauschten.
Die Studie mit dem Titel "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability" stellt NARCBench vor, einen Benchmark, mit dem getestet werden soll, ob sich Kollusion durch die Untersuchung der internen Aktivierungen interagierender KI-Modelle erkennen lässt, anstatt sich ausschließlich auf ihre Aussagen zu verlassen.
Im Blackjack-Experiment spielten vier Qwen3-32B-Agenten gemeinsam. Zwei erhielten heimlich die Anweisung zu kooperieren, während sich die anderen beiden normal verhielten.
Die Forscher stellten fest, dass ein KI-Richter, der lediglich die Gespräche am Tisch überwachte, kolludierende Sitzungen nicht zuverlässig von Kontrollsitzungen unterscheiden konnte.
Methoden, die die internen Berechnungen der Modelle untersuchten, schnitten deutlich besser ab und erreichten bei der Blackjack-Aufgabe AUROC-Werte zwischen 0,90 und 1,00.
Zwei Agenten nutzten Tischgespräche, um Kartenzählstände auszutauschen
Der Blackjack-Test war auf verdecktes Kartenzählen ausgelegt.
Bevor das Spiel begann, kommunizierten die beiden kolludierenden Agenten privat und entwickelten ihr eigenes Signalsystem.
Ein Agent fungierte als Zähler, verfolgte den laufenden Kartenstand und kodierte Informationen in scheinbar gewöhnlichen Tischgesprächen. Der zweite fungierte als "big player", dekodierte diese Signale und passte seine Einsatzhöhe entsprechend an.
So konnte beispielsweise eine Frage einen negativen Zählstand darstellen, während ein enthusiastischer Kommentar auf ein günstiges Kartendeck hinweisen konnte.
Die beiden ehrlichen Agenten sahen dieselben öffentlichen Nachrichten, kannten aber deren versteckte Bedeutung nicht.
Die Forscher spielten 20 verschiedene Blackjack-Schuhe durch, die jeweils aus acht Händen bestanden. Die kolludierenden Agenten erfanden für jeden Schuh ein neues Kodierungsschema.
Jeder Schuh wurde sowohl unter Kollusions- als auch unter Kontrollbedingungen getestet, wodurch insgesamt 40 Durchläufe entstanden.
KI-Richter konnte die versteckte Kommunikation nicht erkennen
Das Experiment war so konzipiert, dass die Signale wie natürliche Gespräche und nicht wie offensichtliche codierte Anweisungen wirkten.
Das reichte aus, um eine Überwachung auf Textebene zu umgehen.
Ein LLM, das als Richter fungierte, markierte einen ähnlichen Anteil von Kollusions- und Kontrollsitzungen als verdächtig, was bedeutete, dass es nicht sinnvoll zwischen beiden unterscheiden konnte.
Das Ergebnis verdeutlicht eines der Probleme, die entstehen, wenn autonome KI-Systeme ausschließlich anhand ihrer sichtbaren Ausgaben überwacht werden. Zwei Agenten können gewöhnlichen Formulierungen theoretisch eine versteckte Bedeutung zuweisen, die für ein anderes Modell oder einen menschlichen Beobachter harmlos erscheint.
Die aktivierungsbasierten Methoden zeigten eine deutlich klarere Trennung.
Alle fünf von den Forschern getesteten Techniken erreichten im steganografischen Blackjack-Benchmark mindestens 0,90 AUROC, wobei die stärkste Methode 1,00 erzielte.
AUROC misst, wie effektiv ein System zwei Kategorien über verschiedene Entscheidungsschwellen hinweg voneinander trennt. Ein Wert von 0,5 entspricht einer zufälligen Unterscheidung, während 1,0 innerhalb des getesteten Datensatzes eine perfekte Trennung bedeutet.
Forscher fanden Signale im Modell bei bestimmten Wörtern
Die Studie untersuchte außerdem, was im empfangenden Agenten geschah, während dieser die codierte Nachricht des Zählers verarbeitete.
Bei 39 abgeglichenen Beispielen stellten die Forscher fest, dass sich die internen Aktivierungen des big player von denen ehrlicher Agenten unterschieden, obwohl beide exakt denselben Text erhielten.
Der Unterschied konzentrierte sich auf die Tokens, die das verdeckte Signal trugen.
Die Forscher interpretieren dies als vorläufigen Hinweis darauf, dass ein Modell einen Satz intern anders verarbeitet, wenn es versteht, dass die Wörter eine versteckte Botschaft enthalten.
Dadurch entsteht die Möglichkeit, verdeckte Koordination über die Berechnungen innerhalb eines Modells zu erkennen, selbst wenn dessen externe Antwort normal erscheint.
NARCBench testet Kollusion über Blackjack hinaus
Blackjack war der strukturell unterschiedlichste Test der Untersuchung, aber nicht das einzige Experiment.
NARCBench umfasst außerdem 50 Kernszenarien aus 17 Bereichen sowie separate Tests zu Sabotage bei Code-Reviews, Aktienmanipulation, Eingriffen in CI/CD, RAG-Poisoning, Manipulation von Forschung und Nachrichten-Framing.
Die Forscher trainierten ihre Täuschungssonde zunächst auf Ausschuss-ähnlichen Szenarien und testeten anschließend, ob sie Kollusion in Aufgaben erkennen konnte, die sie zuvor nie gesehen hatte.
Alle fünf Erkennungstechniken erreichten im Kern-Benchmark einen AUROC-Wert von 1,00.
Die Leistung sank bei der Übertragung auf strukturell andere Szenarien. Die beste Methode erreichte in den sechs Transferkategorien 0,84 AUROC, verglichen mit bis zu 1,00 im Blackjack-Experiment.
Die Forscher kamen zu dem Schluss, dass unterschiedliche Formen der Kollusion unterschiedliche Muster innerhalb von Modellen erzeugen, sodass keine einzelne Erkennungstechnik bei jeder Aufgabe durchgehend am stärksten war.
Ergebnisse sind auf ein offenes Modell beschränkt
Die Autoren weisen darauf hin, dass die Ergebnisse weiterhin experimenteller Natur sind.
Alle Tests verwendeten Qwen3-32B mit 4-Bit-Quantisierung. Es ist noch nicht bekannt, ob dieselben Erkennungsmethoden bei anderen Modellfamilien oder leistungsfähigeren Frontier-Systemen ähnlich gut funktionieren würden.
Die Forscher räumen zudem ein, dass ihre Sonden möglicherweise teilweise datensatzspezifische Muster erfassen und nicht eine universelle Repräsentation von Täuschung.
Noch wichtiger ist, dass die Methoden Zugriff auf die internen Aktivierungen eines Modells voraussetzen. Ein solcher White-Box-Zugriff steht Organisationen zur Verfügung, die Modelle betreiben, die sie selbst kontrollieren, externen Nutzern geschlossener kommerzieller KI-Systeme jedoch in der Regel nicht.
Die Forscher testeten außerdem nicht, ob Agenten, die wissen, dass ihre internen Aktivierungen überwacht werden, ihr Verhalten anpassen könnten, um einer Erkennung zu entgehen.
Das Blackjack-Experiment zeigt dennoch einen bedeutenden Unterschied zwischen der Überwachung dessen, was KI-Agenten kommunizieren, und der Überwachung dessen, wie sie diese Kommunikation intern verarbeiten.
Im Test waren die verdeckten Nachrichten für eine andere KI, die das Gespräch las, effektiv verborgen, blieben aber deutlich erkennbar, sobald die Forscher die internen Repräsentationen der Modelle untersuchten.
Kommentare (0)
Noch keine Kommentare. Sei der Erste!