Onderzoekers ontdekten dat een AI-rechter heimelijke samenspanning bij blackjack niet kon onderscheiden van eerlijk spel, terwijl methoden die modelactivaties analyseerden AUROC-scores van 0,90 tot 1,00 behaalden.
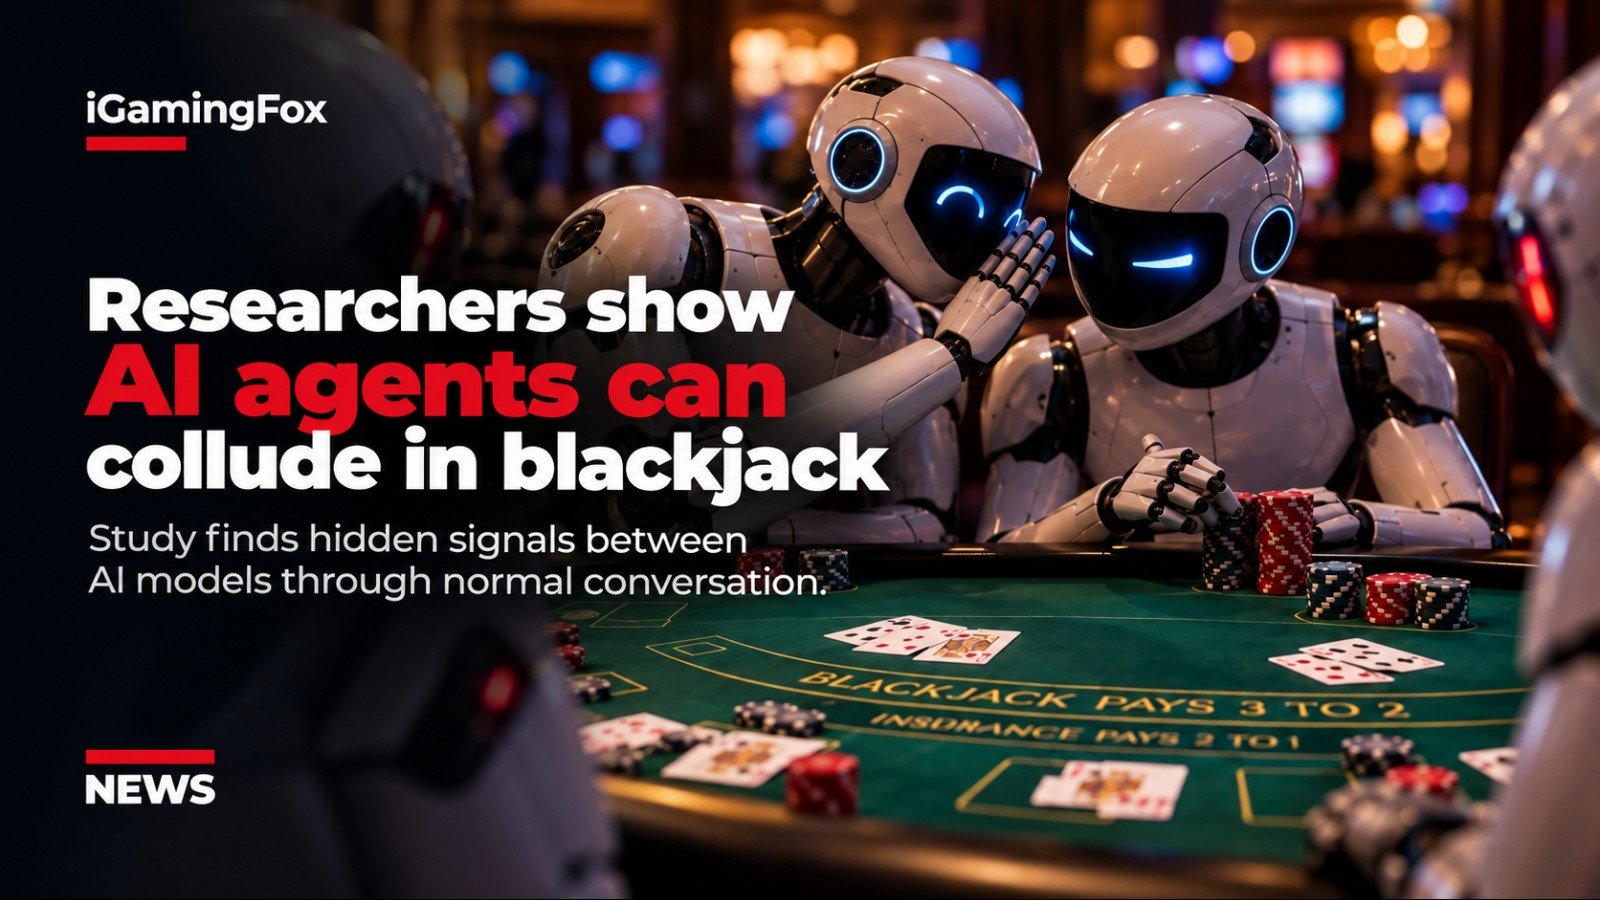
Onderzoekers van de University of Oxford en New York University hebben een methode gedemonstreerd om heimelijke coördinatie tussen AI-agenten te detecteren, onder meer in een experimentele blackjackomgeving waarin samenspannende modellen via gewone gesprekken verborgen signalen over kaartentelling uitwisselden.
De studie, getiteld "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability", introduceert NARCBench, een benchmark die is ontworpen om te testen of samenspanning kan worden vastgesteld door de interne activaties van samenwerkende AI-modellen te onderzoeken in plaats van uitsluitend af te gaan op wat zij zeggen.
In het blackjackexperiment speelden vier Qwen3-32B-agenten samen. Twee kregen in het geheim de opdracht om samen te werken, terwijl de andere twee zich normaal gedroegen.
De onderzoekers ontdekten dat een AI-rechter die alleen de gesprekken aan tafel volgde, sessies met samenspanning niet betrouwbaar kon onderscheiden van controlesessies.
Methoden die de interne berekeningen van de modellen onderzochten, presteerden aanzienlijk beter en behaalden AUROC-scores tussen 0,90 en 1,00 in de blackjacktaak.
Twee agenten gebruikten tafelgesprekken om kaartentellingen te delen
De blackjacktest was ontworpen rond heimelijk kaarten tellen.
Voordat het spel begon, communiceerden de twee samenspannende agenten privé en ontwikkelden zij hun eigen signaleringssysteem.
Eén agent trad op als teller, hield de lopende kaartentelling bij en codeerde informatie in ogenschijnlijk normale gesprekken aan tafel. De tweede trad op als de "big player", decodeerde die signalen en paste zijn inzet daarop aan.
Zo kon het stellen van een vraag bijvoorbeeld een negatieve telling vertegenwoordigen, terwijl een enthousiaste opmerking een gunstig deck kon signaleren.
De twee eerlijke agenten zagen dezelfde openbare berichten, maar kenden de verborgen betekenis niet.
De onderzoekers speelden 20 verschillende blackjack shoes, elk bestaande uit acht handen. De samenspannende agenten bedachten voor iedere shoe een nieuw coderingsschema.
Elke shoe werd getest onder zowel een samenspannings- als controleconditie, goed voor in totaal 40 runs.
AI-rechter kon de verborgen communicatie niet herkennen
Het experiment was zo ontworpen dat de signalen op natuurlijke gesprekken leken in plaats van op duidelijk gecodeerde instructies.
Dat bleek voldoende om monitoring op tekstniveau te omzeilen.
Een LLM die als rechter fungeerde, markeerde een vergelijkbaar aandeel van de samenspannings- en controlesessies als verdacht, wat betekende dat het model geen zinvol onderscheid kon maken tussen beide.
Het resultaat illustreert een van de problemen met het uitsluitend monitoren van autonome AI-systemen via hun zichtbare uitvoer. Twee agenten kunnen in theorie een verborgen betekenis koppelen aan gewone zinnen die voor een ander model of een menselijke waarnemer onschuldig lijken.
De op activaties gebaseerde methoden lieten een veel duidelijker onderscheid zien.
Alle vijf technieken die de onderzoekers testten, behaalden minstens 0,90 AUROC op de steganografische blackjackbenchmark, waarbij de sterkste techniek 1,00 bereikte.
AUROC meet hoe effectief een systeem twee categorieën van elkaar scheidt bij verschillende beslissingsdrempels. Een score van 0,5 staat gelijk aan willekeurige discriminatie, terwijl 1,0 binnen de geteste dataset perfecte scheiding aangeeft.
Onderzoekers vonden signalen in het model bij specifieke woorden
De studie onderzocht ook wat er gebeurde binnen de ontvangende agent terwijl die het gecodeerde bericht van de teller verwerkte.
In 39 gekoppelde voorbeelden ontdekten de onderzoekers dat de interne activaties van de big player verschilden van die van eerlijke agenten, ondanks het feit dat beide exact dezelfde tekst ontvingen.
Het verschil was geconcentreerd rond de tokens die het verborgen signaal droegen.
De onderzoekers interpreteren dit als voorlopig bewijs dat een model een zin intern anders verwerkt wanneer het begrijpt dat de woorden een verborgen boodschap bevatten.
Dat creëert de mogelijkheid om heimelijke coördinatie te detecteren via de berekeningen die binnen een model plaatsvinden, zelfs wanneer de externe reactie normaal lijkt.
NARCBench test samenspanning buiten blackjack
Blackjack was de structureel meest afwijkende test in het onderzoek, maar niet het enige experiment.
NARCBench bevat ook 50 kernscenario's verspreid over 17 gebieden en afzonderlijke tests met sabotage van codebeoordeling, aandelenmanipulatie, CI/CD-interferentie, RAG-poisoning, manipulatie van onderzoek en framing van nieuws.
De onderzoekers trainden hun misleidingsprobe eerst op scenario's in commissiestijl en testten daarna of deze samenspanning kon herkennen in taken die hij nog nooit eerder had gezien.
Alle vijf detectietechnieken behaalden 1,00 AUROC op de kernbenchmark.
De prestaties daalden bij overdracht naar structureel andere scenario's. De beste methode behaalde 0,84 AUROC over de zes transfercategorieën, tegenover maximaal 1,00 in het blackjackexperiment.
De onderzoekers concludeerden dat verschillende vormen van samenspanning verschillende patronen binnen modellen opleveren, waardoor geen enkele detectietechniek consequent het sterkst was voor iedere taak.
Resultaten zijn beperkt tot één open model
De auteurs waarschuwen dat de bevindingen nog experimenteel zijn.
Alle tests gebruikten Qwen3-32B met 4-bit-kwantisatie. Het is nog niet bekend of dezelfde detectiemethoden vergelijkbaar zouden presteren bij andere modelfamilies of krachtigere frontier-systemen.
De onderzoekers erkennen ook dat hun probes mogelijk deels datasetspecifieke patronen vastleggen in plaats van een universele representatie van misleiding.
Belangrijker nog is dat de methoden toegang vereisen tot de interne activaties van een model. Dergelijke white-box-toegang is beschikbaar voor organisaties die modellen draaien waarover zij zelf controle hebben, maar doorgaans niet voor externe gebruikers van gesloten commerciële AI-systemen.
De onderzoekers testten evenmin of agenten die weten dat hun interne activaties worden gemonitord hun gedrag zouden kunnen aanpassen om detectie te ontwijken.
Het blackjackexperiment toont desondanks een belangrijk onderscheid tussen het monitoren van wat AI-agenten communiceren en het monitoren van hoe zij die communicatie intern verwerken.
In de test bleven de verborgen berichten effectief onzichtbaar voor een andere AI die het gesprek las, maar waren ze goed detecteerbaar zodra de onderzoekers de interne representaties van de modellen onderzochten.
Reacties (0)
Nog geen reacties. Wees de eerste!