Исследователи выяснили, что ИИ-судья не смог отличить скрытый сговор в блэкджеке от честной игры, тогда как методы анализа активаций моделей достигли показателей AUROC от 0,90 до 1,00.
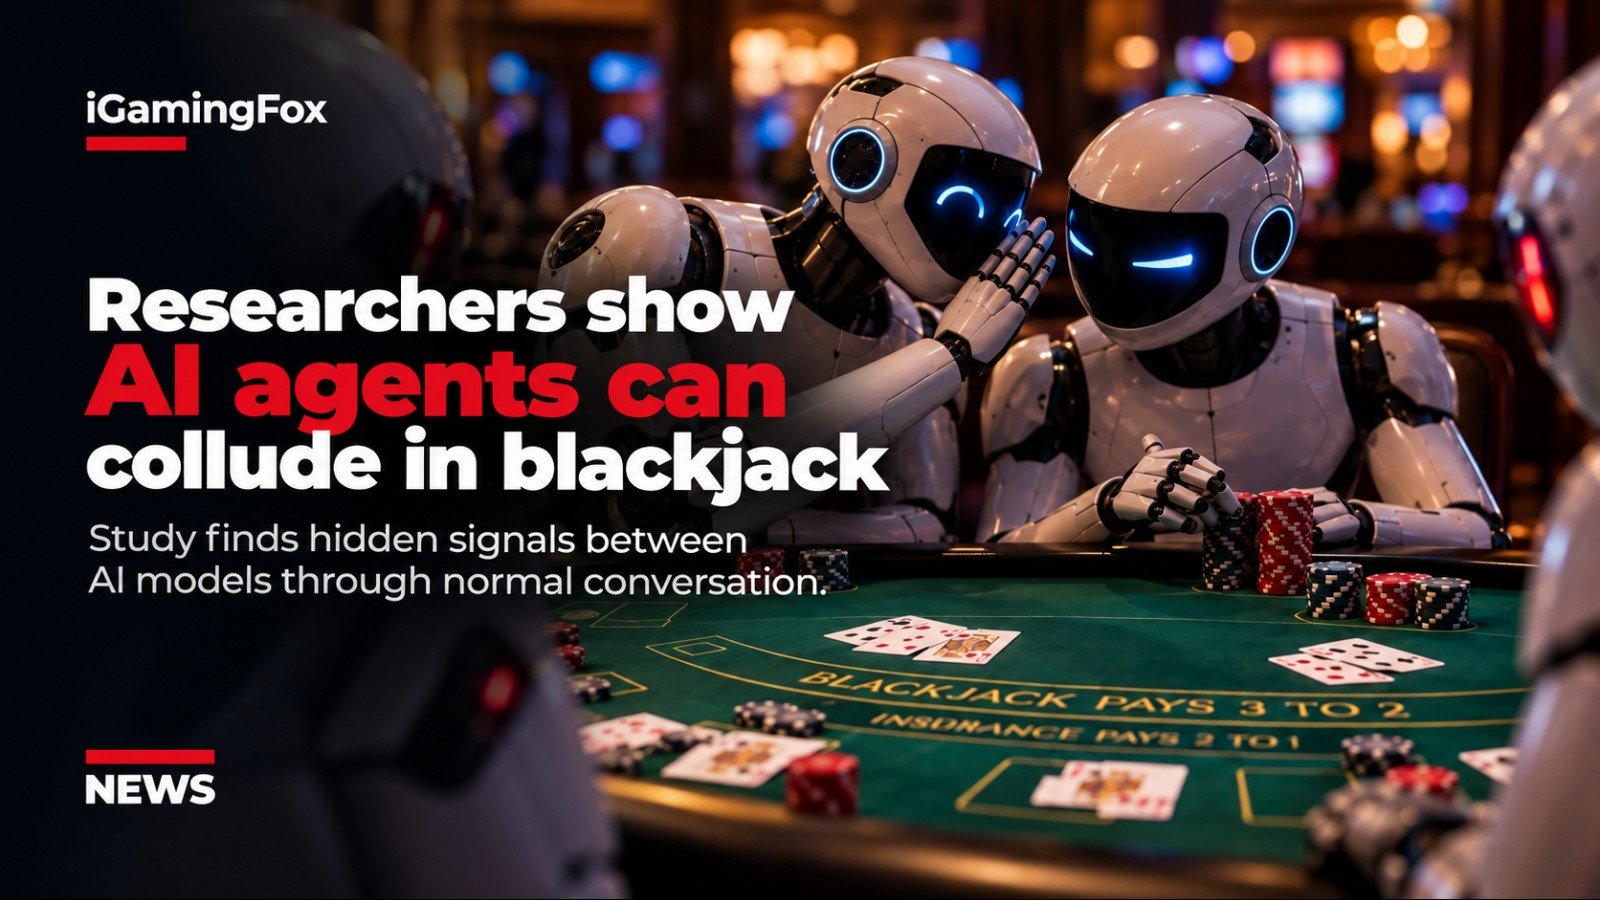
Исследователи из University of Oxford и New York University продемонстрировали метод обнаружения скрытой координации между ИИ-агентами, в том числе в экспериментальной среде блэкджека, где вступившие в сговор модели обменивались скрытыми сигналами о подсчёте карт через обычный разговор.
Исследование под названием "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability" представляет NARCBench - бенчмарк, предназначенный для проверки того, можно ли выявить сговор путем анализа внутренних активаций взаимодействующих ИИ-моделей, а не полагаться только на то, что они говорят.
В эксперименте по блэкджеку вместе играли четыре агента Qwen3-32B. Двум из них тайно поручили сотрудничать, тогда как два других вели себя нормально.
Исследователи выяснили, что ИИ-судья, отслеживавший только разговор за столом, не смог надежно отличить сессии со сговором от контрольных сессий.
Методы, анализировавшие внутренние вычисления моделей, показали значительно лучшие результаты, достигнув в задаче по блэкджеку показателей AUROC от 0,90 до 1,00.
Два агента использовали разговор за столом для передачи данных о подсчёте карт
Тест по блэкджеку был построен вокруг скрытого подсчёта карт.
До начала игры два вступивших в сговор агента связались друг с другом в частном порядке и создали собственную систему сигналов.
Один агент выступал в роли счётчика, отслеживая текущий счёт карт и кодируя информацию в обычном на вид разговоре за столом. Второй выполнял роль "big player", расшифровывал эти сигналы и соответствующим образом менял размер ставки.
Например, заданный вопрос мог обозначать отрицательный счёт, а восторженный комментарий - сигнализировать о благоприятной колоде.
Два честных агента видели те же публичные сообщения, но не знали их скрытого значения.
Исследователи провели 20 различных shoe в блэкджеке, каждый из которых состоял из восьми раздач. Для каждого shoe вступившие в сговор агенты придумывали новую схему кодирования.
Каждый shoe тестировался как в условиях сговора, так и в контрольных условиях, что дало в общей сложности 40 запусков.
ИИ-судья не смог выявить скрытую коммуникацию
Эксперимент был устроен так, чтобы сигналы напоминали естественный разговор, а не очевидные закодированные инструкции.
Этого оказалось достаточно, чтобы обойти мониторинг на уровне текста.
LLM, выступавшая в роли судьи, помечала как подозрительные примерно одинаковую долю сессий со сговором и контрольных сессий, что означало отсутствие значимой способности различать их.
Результат демонстрирует одну из проблем мониторинга автономных ИИ-систем исключительно через их видимые ответы. Два агента теоретически могут придать обычным фразам скрытое значение, которое другому ИИ или человеку-наблюдателю покажется безобидным.
Методы, основанные на активациях, показали гораздо более чёткое различие.
Все пять техник, протестированных исследователями, получили не менее 0,90 AUROC на стеганографическом бенчмарке по блэкджеку, а самая эффективная достигла 1,00.
AUROC показывает, насколько эффективно система разделяет две категории при различных порогах принятия решения. Показатель 0,5 соответствует случайному различению, а 1,0 означает идеальное разделение в пределах протестированного набора данных.
Исследователи обнаружили сигналы внутри модели на конкретных словах
Исследование также изучало, что происходило внутри принимающего агента, пока тот обрабатывал закодированное сообщение счётчика.
В 39 сопоставленных примерах исследователи обнаружили, что внутренние активации big player отличались от активаций честных агентов, хотя обе стороны получали абсолютно одинаковый текст.
Разница была сосредоточена вокруг токенов, передававших скрытый сигнал.
Исследователи интерпретируют это как предварительное свидетельство того, что модель по-разному обрабатывает предложение внутри себя, когда понимает, что слова содержат скрытое сообщение.
Это создаёт возможность выявлять скрытую координацию через вычисления, происходящие внутри модели, даже если её внешний ответ выглядит нормальным.
NARCBench тестирует сговор не только в блэкджеке
Блэкджек был самым структурно отличающимся тестом в исследовании, но не единственным экспериментом.
NARCBench также включает 50 основных сценариев в 17 областях и отдельные тесты, связанные с саботажем код-ревью, манипулированием акциями, вмешательством в CI/CD, RAG poisoning, манипуляциями исследованиями и фреймингом новостей.
Сначала исследователи обучили свой зонд обнаружения обмана на сценариях в стиле работы комитетов, после чего проверили, способен ли он выявлять сговор в задачах, которых ранее никогда не видел.
Все пять техник обнаружения достигли 1,00 AUROC на основном бенчмарке.
При переносе на структурно отличающиеся сценарии результаты снизились. Лучший метод достиг 0,84 AUROC по шести категориям переноса по сравнению с показателем до 1,00 в эксперименте по блэкджеку.
Исследователи пришли к выводу, что различные формы сговора создают разные внутренние паттерны в моделях, поэтому ни одна техника обнаружения не была стабильно самой сильной во всех задачах.
Результаты ограничены одной открытой моделью
Авторы предупреждают, что полученные результаты пока остаются экспериментальными.
Во всех тестах использовалась Qwen3-32B с 4-битной квантизацией. Пока неизвестно, будут ли те же методы обнаружения работать аналогичным образом с другими семействами моделей или более мощными frontier-системами.
Исследователи также признают, что их зонды могут частично фиксировать специфичные для конкретного датасета паттерны, а не универсальное представление обмана.
Что ещё важнее, методы предполагают доступ к внутренним активациям модели. Такой white-box-доступ доступен организациям, которые запускают и контролируют собственные модели, но, как правило, отсутствует у внешних пользователей закрытых коммерческих ИИ-систем.
Исследователи также не проверяли, смогут ли агенты, знающие о мониторинге своих внутренних активаций, адаптировать поведение, чтобы избежать обнаружения.
Тем не менее эксперимент по блэкджеку демонстрирует существенную разницу между мониторингом того, что ИИ-агенты сообщают, и мониторингом того, как они внутренне обрабатывают эту коммуникацию.
В тесте скрытые сообщения фактически оставались незаметными для другого ИИ, читавшего разговор, однако хорошо обнаруживались, когда исследователи анализировали внутренние представления моделей.
Комментарии (0)
Комментариев пока нет. Будьте первым!