Badacze ustalili, że sędzia AI nie potrafił odróżnić ukrytej zmowy w blackjacku od uczciwej gry, podczas gdy metody analizujące aktywacje modeli osiągnęły wyniki AUROC od 0,90 do 1,00.
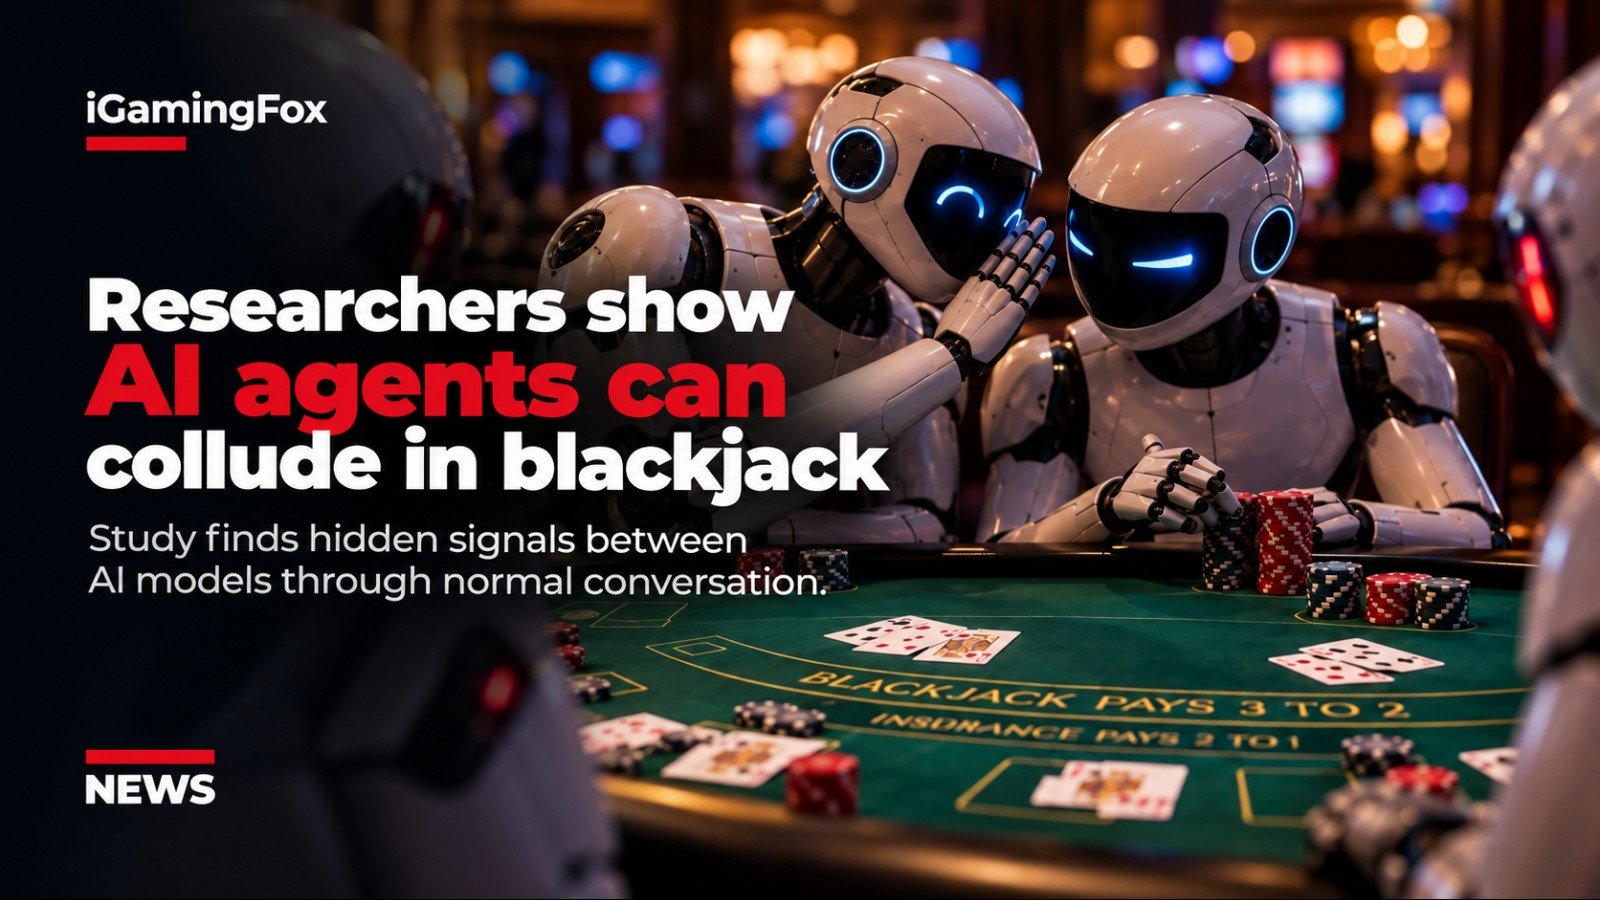
Badacze z University of Oxford i New York University zaprezentowali metodę wykrywania ukrytej koordynacji między agentami AI, w tym w eksperymentalnym środowisku blackjacka, w którym współpracujące modele wymieniały ukryte sygnały dotyczące liczenia kart za pośrednictwem zwykłej rozmowy.
Badanie zatytułowane "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability" przedstawia NARCBench, benchmark zaprojektowany do sprawdzania, czy zmowę można wykrywać poprzez analizę wewnętrznych aktywacji współdziałających modeli AI, zamiast polegać wyłącznie na tym, co mówią.
W eksperymencie z blackjackiem wspólnie grały cztery agenty Qwen3-32B. Dwa z nich otrzymały potajemne polecenie współpracy, podczas gdy pozostałe dwa zachowywały się normalnie.
Badacze stwierdzili, że sędzia AI monitorujący wyłącznie rozmowę przy stole nie był w stanie wiarygodnie odróżnić sesji ze zmową od sesji kontrolnych.
Metody analizujące wewnętrzne obliczenia modeli radziły sobie znacznie lepiej, osiągając w zadaniu blackjacka wyniki AUROC od 0,90 do 1,00.
Dwaj agenci wykorzystywali rozmowę przy stole do przekazywania wyników liczenia kart
Test blackjacka został zaprojektowany wokół ukrytego liczenia kart.
Przed rozpoczęciem gry dwaj współpracujący agenci komunikowali się prywatnie i stworzyli własny system sygnałów.
Jeden agent pełnił funkcję liczącego, śledził bieżący licznik kart i kodował informacje w pozornie zwyczajnej rozmowie przy stole. Drugi działał jako "big player", odkodowując te sygnały i odpowiednio zmieniając wysokość zakładu.
Na przykład zadanie pytania mogło oznaczać ujemny wynik liczenia, natomiast entuzjastyczny komentarz mógł sygnalizować korzystny układ kart.
Dwaj uczciwi agenci widzieli te same publiczne wiadomości, ale nie znali ich ukrytego znaczenia.
Badacze przeprowadzili 20 różnych shoe blackjacka, z których każde składało się z ośmiu rozdań. Współpracujące agenty opracowywały nowy schemat kodowania dla każdego shoe.
Każde shoe testowano zarówno w warunkach zmowy, jak i w warunkach kontrolnych, co dało łącznie 40 przebiegów.
Sędzia AI nie potrafił zidentyfikować ukrytej komunikacji
Eksperyment został zaprojektowany tak, aby sygnały przypominały naturalną rozmowę, a nie oczywiste zakodowane instrukcje.
To wystarczyło, aby pokonać monitoring na poziomie tekstu.
LLM pełniący funkcję sędziego oznaczył podobny odsetek sesji ze zmową i kontrolnych jako podejrzane, co oznaczało, że nie był w stanie w istotny sposób rozróżnić obu grup.
Wynik pokazuje jeden z problemów związanych z monitorowaniem autonomicznych systemów AI wyłącznie poprzez ich widoczne odpowiedzi. Dwa agenty mogą teoretycznie przypisać ukryte znaczenie zwykłym zwrotom, które dla innego modelu lub człowieka wyglądają niewinnie.
Metody oparte na aktywacjach pokazały znacznie wyraźniejsze rozróżnienie.
Wszystkie pięć technik testowanych przez badaczy uzyskało co najmniej 0,90 AUROC w steganograficznym benchmarku blackjacka, a najlepsza osiągnęła 1,00.
AUROC mierzy skuteczność systemu w rozdzielaniu dwóch kategorii przy różnych progach decyzyjnych. Wynik 0,5 odpowiada losowej klasyfikacji, natomiast 1,0 oznacza idealne rozdzielenie w testowanym zbiorze danych.
Badacze znaleźli sygnały wewnątrz modelu przy określonych słowach
Badanie sprawdziło również, co działo się wewnątrz agenta odbierającego podczas przetwarzania zakodowanej wiadomości od liczącego.
W 39 dopasowanych przykładach badacze odkryli, że wewnętrzne aktywacje big playera różniły się od aktywacji uczciwych agentów, mimo że obie grupy otrzymywały dokładnie ten sam tekst.
Różnica koncentrowała się wokół tokenów zawierających ukryty sygnał.
Badacze interpretują to jako wstępny dowód na to, że model inaczej przetwarza wewnętrznie zdanie, gdy rozumie, że słowa zawierają ukrytą wiadomość.
Stwarza to możliwość wykrywania ukrytej koordynacji poprzez analizę obliczeń zachodzących wewnątrz modelu, nawet jeśli jego zewnętrzna odpowiedź wygląda normalnie.
NARCBench testuje zmowę także poza blackjackiem
Blackjack był najbardziej odmiennym strukturalnie testem w badaniu, ale nie jedynym eksperymentem.
NARCBench obejmuje również 50 głównych scenariuszy w 17 obszarach oraz osobne testy dotyczące sabotażu przeglądu kodu, manipulacji akcjami, zakłócania CI/CD, zatruwania RAG, manipulacji badaniami i sposobu przedstawiania wiadomości.
Badacze najpierw trenowali swoją sondę wykrywającą oszustwo na scenariuszach przypominających pracę komisji, a następnie sprawdzili, czy potrafi identyfikować zmowę w zadaniach, których wcześniej nigdy nie widziała.
Wszystkie pięć technik wykrywania osiągnęło 1,00 AUROC w głównym benchmarku.
Wyniki spadły po przeniesieniu na strukturalnie odmienne scenariusze. Najlepsza metoda osiągnęła 0,84 AUROC w sześciu kategoriach transferowych, wobec maksymalnie 1,00 w eksperymencie z blackjackiem.
Badacze stwierdzili, że różne formy zmowy generują odmienne wzorce wewnątrz modeli, dlatego żadna pojedyncza technika wykrywania nie była konsekwentnie najlepsza we wszystkich zadaniach.
Wyniki są ograniczone do jednego otwartego modelu
Autorzy zaznaczają, że wyniki nadal mają charakter eksperymentalny.
We wszystkich testach wykorzystano Qwen3-32B z 4-bitową kwantyzacją. Nie wiadomo jeszcze, czy te same metody wykrywania działałyby podobnie w innych rodzinach modeli lub w bardziej zaawansowanych systemach frontier.
Badacze przyznają również, że ich sondy mogą częściowo wychwytywać wzorce specyficzne dla danego zbioru danych, a nie uniwersalną reprezentację oszustwa.
Co ważniejsze, metody zakładają dostęp do wewnętrznych aktywacji modelu. Taki dostęp white-box jest dostępny dla organizacji uruchamiających modele, nad którymi mają kontrolę, ale zazwyczaj nie dla zewnętrznych użytkowników zamkniętych komercyjnych systemów AI.
Badacze nie sprawdzili również, czy agenci świadomi monitorowania swoich wewnętrznych aktywacji mogliby dostosować zachowanie w celu uniknięcia wykrycia.
Eksperyment z blackjackiem pokazuje jednak istotną różnicę między monitorowaniem tego, co agenci AI komunikują, a monitorowaniem sposobu, w jaki wewnętrznie przetwarzają tę komunikację.
W teście ukryte wiadomości były skutecznie niewidoczne dla innej AI czytającej rozmowę, ale pozostawały bardzo łatwe do wykrycia, gdy badacze analizowali wewnętrzne reprezentacje modeli.
Komentarze (0)
Brak komentarzy. Bądź pierwszy!