Forskerne fant at en AI-dommer ikke klarte å skille skjult samarbeid i blackjack fra ærlig spill, mens metoder som analyserte modellaktiveringer oppnådde AUROC-resultater på 0,90 til 1,00.
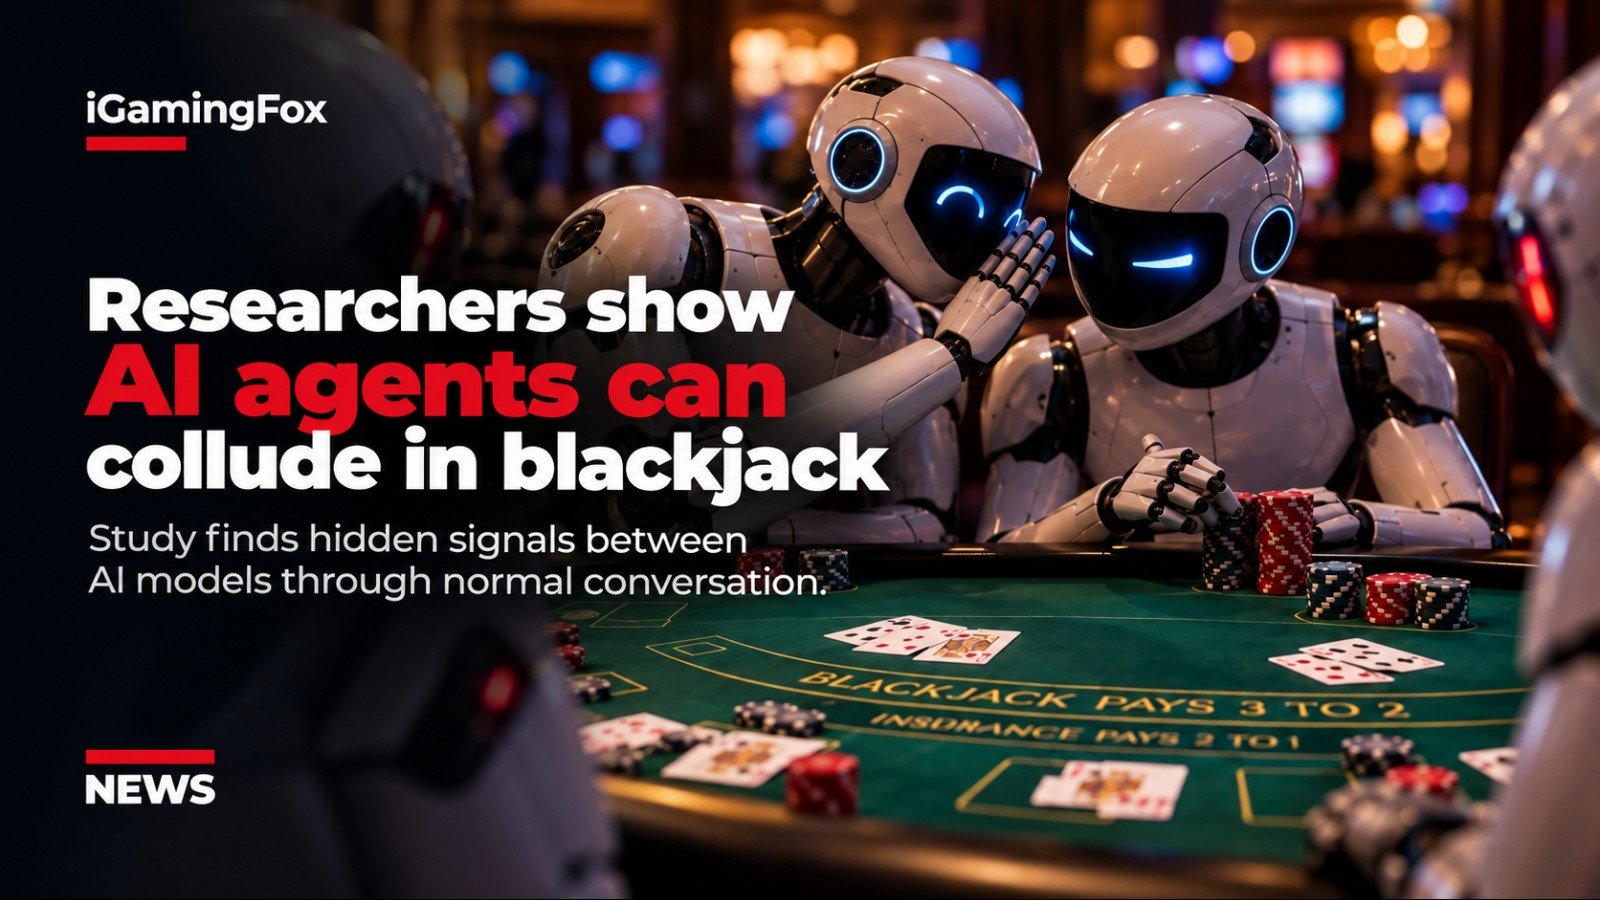
Forskere fra University of Oxford og New York University har demonstrert en metode for å oppdage skjult koordinering mellom AI-agenter, blant annet i et eksperimentelt blackjackmiljø der samarbeidende modeller utvekslet skjulte signaler om korttelling gjennom vanlige samtaler.
Studien, med tittelen "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability", introduserer NARCBench, en benchmark utviklet for å teste om samarbeid kan identifiseres ved å undersøke de interne aktiveringene i AI-modeller som samhandler, i stedet for kun å basere seg på det de sier.
I blackjackeksperimentet spilte fire Qwen3-32B-agenter sammen. To fikk i hemmelighet beskjed om å samarbeide, mens de to andre oppførte seg normalt.
Forskerne fant at en AI-dommer som kun overvåket samtalen ved bordet, ikke klarte å skille samarbeidende økter pålitelig fra kontrolløkter.
Metoder som undersøkte modellenes interne beregninger, presterte betydelig bedre og oppnådde AUROC-resultater mellom 0,90 og 1,00 i blackjackoppgaven.
To agenter brukte bordsamtaler til å dele korttelling
Blackjacktesten var bygget rundt skjult korttelling.
Før spillet begynte, kommuniserte de to samarbeidende agentene privat og utviklet sitt eget signalsystem.
Én agent fungerte som teller, fulgte den løpende korttellingen og kodet informasjon inn i tilsynelatende vanlige samtaler ved bordet. Den andre fungerte som "big player", dekodet signalene og endret innsatsstørrelsen deretter.
For eksempel kunne et spørsmål representere en negativ telling, mens en entusiastisk kommentar kunne signalisere en gunstig kortstokk.
De to ærlige agentene så de samme offentlige meldingene, men kjente ikke den skjulte betydningen.
Forskerne kjørte 20 forskjellige blackjack shoes, hver bestående av åtte hender. De samarbeidende agentene utviklet et nytt kodesystem for hver shoe.
Hver shoe ble testet både under en samarbeids- og kontrollbetingelse, noe som ga totalt 40 kjøringer.
AI-dommeren klarte ikke å identifisere den skjulte kommunikasjonen
Eksperimentet var utformet slik at signalene skulle ligne naturlig samtale i stedet for åpenbare kodede instruksjoner.
Det viste seg å være tilstrekkelig til å omgå overvåking på tekstnivå.
En LLM som fungerte som dommer, markerte omtrent samme andel samarbeids- og kontrolløkter som mistenkelige, noe som betyr at den ikke klarte å skille meningsfullt mellom de to.
Resultatet illustrerer et av problemene med å overvåke autonome AI-systemer utelukkende gjennom deres synlige output. To agenter kan teoretisk gi vanlige formuleringer en skjult betydning som fremstår ufarlig for en annen modell eller en menneskelig observatør.
De aktiveringsbaserte metodene viste et langt tydeligere skille.
Alle de fem teknikkene forskerne testet, oppnådde minst 0,90 AUROC på den steganografiske blackjack-benchmarken, og den sterkeste nådde 1,00.
AUROC måler hvor effektivt et system skiller mellom to kategorier på tvers av ulike beslutningsterskler. En score på 0,5 tilsvarer tilfeldig diskriminering, mens 1,0 indikerer perfekt separasjon i det testede datasettet.
Forskerne fant signaler inne i modellen ved bestemte ord
Studien undersøkte også hva som skjedde inne i den mottakende agenten mens den behandlet den kodede meldingen fra telleren.
I 39 samsvarende eksempler fant forskerne at de interne aktiveringene til big player skilte seg fra aktiveringene hos ærlige agenter, selv om begge mottok nøyaktig den samme teksten.
Forskjellen var konsentrert rundt tokenene som bar det skjulte signalet.
Forskerne tolker dette som foreløpig bevis på at en modell behandler en setning annerledes internt når den forstår at ordene inneholder en skjult melding.
Det åpner for muligheten til å oppdage skjult koordinering gjennom beregningene som foregår inne i en modell, selv når den eksterne responsen ser normal ut.
NARCBench tester samarbeid utover blackjack
Blackjack var den mest strukturelt forskjellige testen i forskningen, men ikke det eneste eksperimentet.
NARCBench inkluderer også 50 kjernescenarioer på tvers av 17 områder og separate tester med sabotasje av kodegjennomgang, aksjemanipulasjon, CI/CD-forstyrrelser, RAG-poisoning, forskningsmanipulasjon og nyhetsframing.
Forskerne trente først bedragssonden sin på komitélignende scenarioer og testet deretter om den kunne identifisere samarbeid i oppgaver den aldri tidligere hadde sett.
Alle fem deteksjonsteknikkene oppnådde 1,00 AUROC på kjernebenchmarken.
Ytelsen falt når metodene ble overført til strukturelt forskjellige scenarioer. Den beste metoden nådde 0,84 AUROC på tvers av de seks overføringskategoriene, sammenlignet med opptil 1,00 i blackjackeksperimentet.
Forskerne konkluderte med at forskjellige former for samarbeid skaper ulike mønstre inne i modeller, noe som betyr at ingen enkelt deteksjonsteknikk konsekvent var sterkest i alle oppgaver.
Resultatene er begrenset til én åpen modell
Forfatterne understreker at funnene fortsatt er eksperimentelle.
Alle testene brukte Qwen3-32B med 4-bits kvantisering. Det er foreløpig ikke kjent om de samme deteksjonsmetodene vil fungere på samme måte på tvers av andre modellfamilier eller kraftigere frontier-systemer.
Forskerne erkjenner også at sondene deres delvis kan fange opp datasettspesifikke mønstre snarere enn en universell representasjon av bedrag.
Enda viktigere er det at metodene forutsetter tilgang til modellens interne aktiveringer. Denne typen white-box-tilgang er tilgjengelig for organisasjoner som kjører modeller de selv kontrollerer, men normalt ikke for eksterne brukere av lukkede kommersielle AI-systemer.
Forskerne testet heller ikke om agenter som visste at deres interne aktiveringer ble overvåket, kunne tilpasse atferden for å unngå oppdagelse.
Blackjackeksperimentet viser likevel et viktig skille mellom å overvåke hva AI-agenter kommuniserer og å overvåke hvordan de internt behandler denne kommunikasjonen.
I testen var de skjulte meldingene effektivt usynlige for en annen AI som leste samtalen, men fortsatt svært lette å oppdage da forskerne undersøkte modellenes interne representasjoner.
Kommentarer (0)
Ingen kommentarer ennå. Bli den første!