I ricercatori hanno scoperto che un giudice IA non riusciva a distinguere la collusione nascosta nel blackjack dal gioco regolare, mentre i metodi che analizzavano le attivazioni dei modelli hanno raggiunto punteggi AUROC compresi tra 0,90 e 1,00.
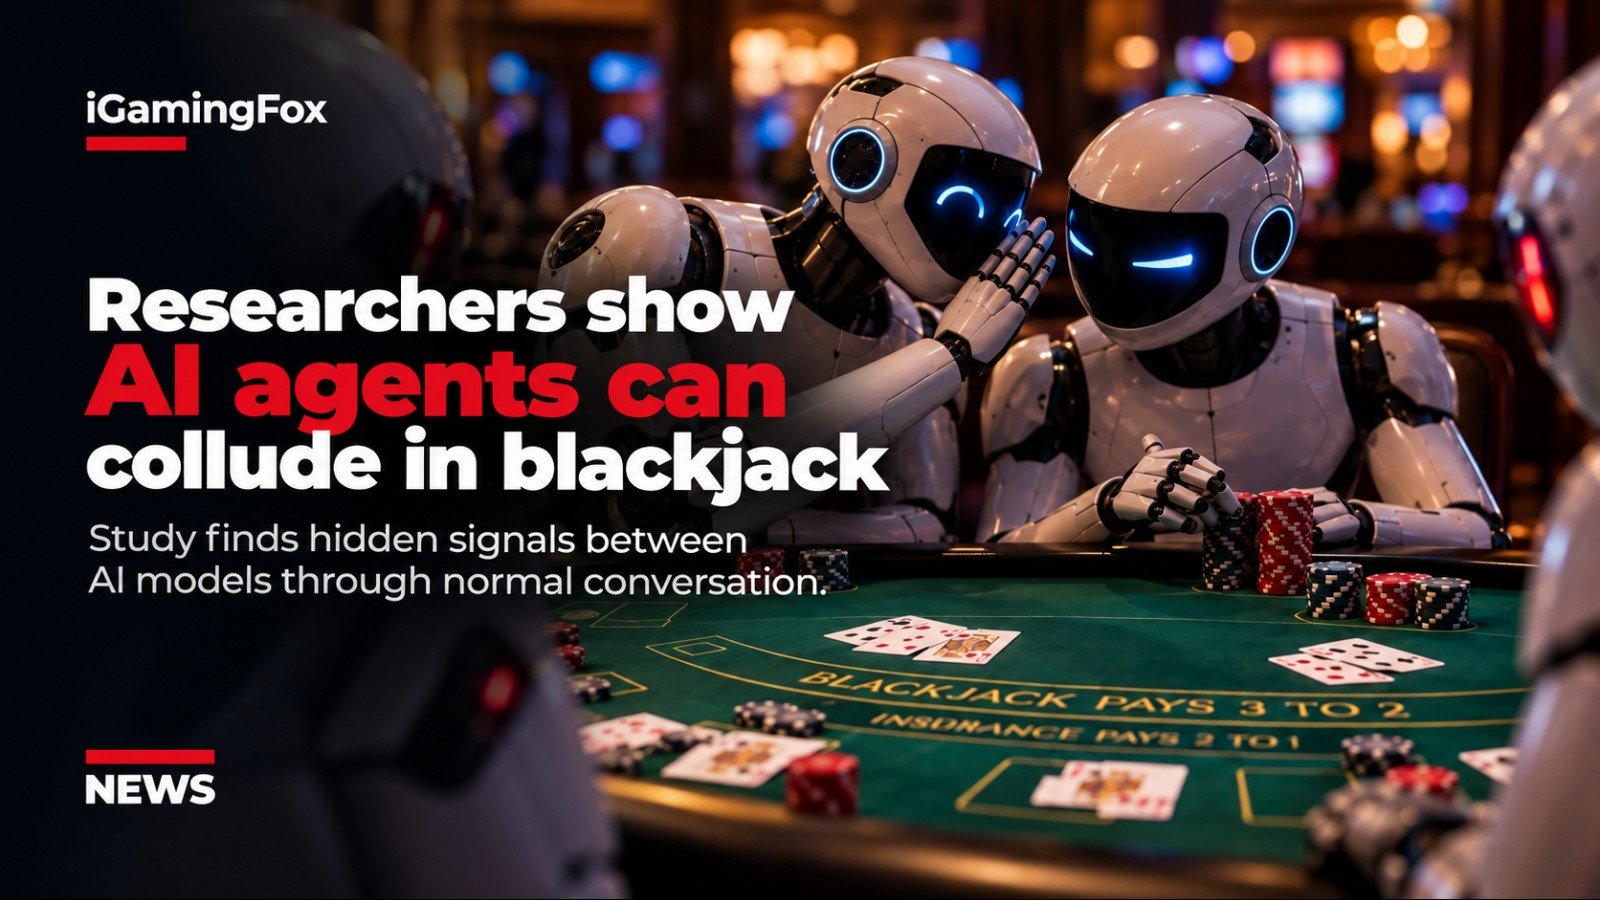
Ricercatori della University of Oxford e della New York University hanno dimostrato un metodo per rilevare il coordinamento nascosto tra agenti IA, anche in un ambiente sperimentale di blackjack in cui modelli collusivi si scambiavano segnali nascosti sul conteggio delle carte attraverso normali conversazioni.
Lo studio, intitolato "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability", introduce NARCBench, un benchmark progettato per verificare se la collusione possa essere identificata esaminando le attivazioni interne dei modelli IA che interagiscono tra loro, anziché basarsi soltanto su ciò che dicono.
Nell'esperimento di blackjack, quattro agenti Qwen3-32B hanno giocato insieme. Due sono stati segretamente istruiti a cooperare, mentre gli altri due si sono comportati normalmente.
I ricercatori hanno scoperto che un giudice IA che monitorava soltanto la conversazione al tavolo non riusciva a distinguere in modo affidabile le sessioni collusive da quelle di controllo.
I metodi che esaminavano i calcoli interni dei modelli hanno ottenuto risultati nettamente migliori, raggiungendo punteggi AUROC compresi tra 0,90 e 1,00 nel compito di blackjack.
Due agenti hanno usato le conversazioni al tavolo per condividere il conteggio delle carte
Il test di blackjack è stato progettato attorno al conteggio nascosto delle carte.
Prima dell'inizio del gioco, i due agenti collusivi hanno comunicato in privato e creato un proprio sistema di segnalazione.
Un agente agiva come contatore, monitorando il conteggio corrente delle carte e codificando le informazioni in conversazioni apparentemente normali al tavolo. Il secondo agiva come "big player", decodificando quei segnali e modificando di conseguenza l'entità della puntata.
Per esempio, fare una domanda poteva rappresentare un conteggio negativo, mentre un commento entusiasta poteva segnalare un mazzo favorevole.
I due agenti onesti vedevano gli stessi messaggi pubblici, ma non ne conoscevano il significato nascosto.
I ricercatori hanno eseguito 20 diversi shoe di blackjack, ciascuno composto da otto mani. Gli agenti collusivi hanno inventato un nuovo schema di codifica per ogni shoe.
Ogni shoe è stato testato sia in una condizione di collusione sia in una condizione di controllo, per un totale di 40 esecuzioni.
Il giudice IA non è riuscito a individuare la comunicazione nascosta
L'esperimento è stato progettato affinché i segnali assomigliassero a una conversazione naturale anziché a evidenti istruzioni codificate.
Questo si è rivelato sufficiente per superare il monitoraggio a livello testuale.
Un LLM che agiva come giudice ha segnalato come sospetta una percentuale simile di sessioni collusive e di controllo, il che significa che non riusciva a discriminare in modo significativo tra le due.
Il risultato evidenzia uno dei problemi del monitoraggio dei sistemi IA autonomi esclusivamente attraverso i loro output visibili. Due agenti possono teoricamente attribuire un significato nascosto a frasi normali che appaiono innocue a un altro modello o a un osservatore umano.
I metodi basati sulle attivazioni hanno mostrato una distinzione molto più netta.
Tutte e cinque le tecniche testate dai ricercatori hanno registrato almeno 0,90 AUROC nel benchmark steganografico di blackjack, con la migliore che ha raggiunto 1,00.
AUROC misura l'efficacia con cui un sistema separa due categorie attraverso diverse soglie decisionali. Un punteggio di 0,5 equivale a una discriminazione casuale, mentre 1,0 indica una separazione perfetta all'interno del dataset testato.
I ricercatori hanno trovato segnali all'interno del modello in corrispondenza di parole specifiche
Lo studio ha inoltre esaminato ciò che accadeva all'interno dell'agente ricevente mentre elaborava il messaggio codificato del contatore.
In 39 esempi abbinati, i ricercatori hanno scoperto che le attivazioni interne del big player differivano da quelle degli agenti onesti, nonostante entrambi ricevessero esattamente lo stesso testo.
La differenza era concentrata intorno ai token che trasportavano il segnale nascosto.
I ricercatori interpretano questo risultato come una prova preliminare del fatto che un modello elabora internamente una frase in modo diverso quando comprende che le parole contengono un messaggio nascosto.
Questo crea la possibilità di rilevare il coordinamento nascosto attraverso i calcoli che avvengono all'interno di un modello anche quando la sua risposta esterna appare normale.
NARCBench testa la collusione oltre il blackjack
Il blackjack è stato il test strutturalmente più diverso della ricerca, ma non l'unico esperimento.
NARCBench include anche 50 scenari principali in 17 aree e test separati riguardanti sabotaggio della revisione del codice, manipolazione azionaria, interferenze CI/CD, RAG poisoning, manipolazione della ricerca e framing delle notizie.
I ricercatori hanno inizialmente addestrato la loro sonda di inganno su scenari in stile comitato, quindi hanno testato se fosse in grado di identificare la collusione in compiti mai visti prima.
Tutte e cinque le tecniche di rilevamento hanno raggiunto 1,00 AUROC nel benchmark principale.
Le prestazioni sono diminuite quando i metodi sono stati trasferiti a scenari strutturalmente diversi. Il metodo migliore ha raggiunto 0,84 AUROC nelle sei categorie di trasferimento, rispetto a un massimo di 1,00 nell'esperimento di blackjack.
I ricercatori hanno concluso che forme diverse di collusione producono schemi diversi all'interno dei modelli, il che significa che nessuna singola tecnica di rilevamento è risultata costantemente la migliore in ogni compito.
I risultati sono limitati a un solo modello aperto
Gli autori avvertono che i risultati restano sperimentali.
Tutti i test hanno utilizzato Qwen3-32B con quantizzazione a 4 bit. Non è ancora noto se gli stessi metodi di rilevamento funzionerebbero in modo simile con altre famiglie di modelli o con sistemi frontier più potenti.
I ricercatori riconoscono inoltre che le loro sonde potrebbero catturare in parte schemi specifici del dataset anziché una rappresentazione universale dell'inganno.
Ancora più importante, i metodi presuppongono l'accesso alle attivazioni interne di un modello. Questo tipo di accesso white-box è disponibile per le organizzazioni che eseguono modelli sotto il proprio controllo, ma generalmente non per gli utenti esterni di sistemi IA commerciali chiusi.
I ricercatori non hanno inoltre verificato se agenti consapevoli del monitoraggio delle proprie attivazioni interne potrebbero adattare il loro comportamento per evitare il rilevamento.
L'esperimento di blackjack dimostra comunque una differenza significativa tra il monitoraggio di ciò che gli agenti IA comunicano e il monitoraggio di come elaborano internamente tale comunicazione.
Nel test, i messaggi nascosti erano effettivamente invisibili a un'altra IA che leggeva la conversazione, ma rimanevano altamente rilevabili quando i ricercatori esaminavano le rappresentazioni interne dei modelli.
Commenti (0)
Ancora nessun commento. Sii il primo!