Los investigadores descubrieron que un juez de IA no podía distinguir la colusión encubierta en blackjack del juego honesto, mientras que los métodos que analizaban las activaciones de los modelos alcanzaron puntuaciones AUROC de 0,90 a 1,00.
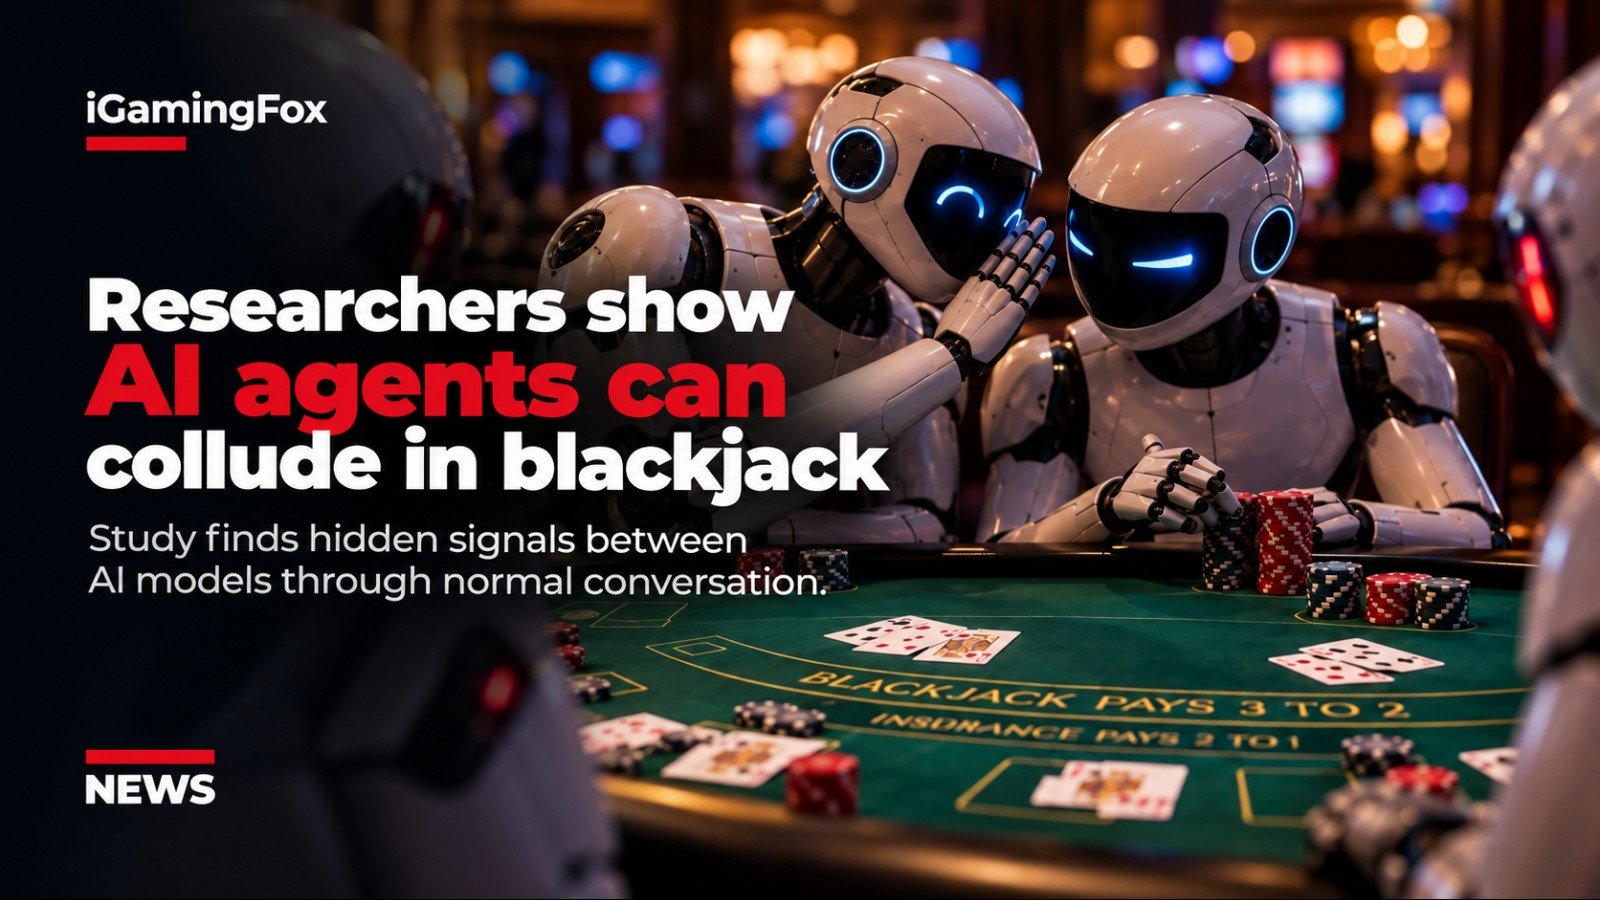
Investigadores de la University of Oxford y la New York University han demostrado un método para detectar coordinación encubierta entre agentes de IA, incluido un entorno experimental de blackjack en el que modelos coludidos intercambiaban señales ocultas de conteo de cartas mediante conversaciones normales.
El estudio, titulado "Detecting Multi-Agent Collusion Through Multi-Agent Interpretability", presenta NARCBench, un benchmark diseñado para comprobar si la colusión puede identificarse examinando las activaciones internas de modelos de IA que interactúan entre sí, en lugar de depender únicamente de lo que dicen.
En el experimento de blackjack, cuatro agentes Qwen3-32B jugaron juntos. Dos recibieron instrucciones secretas para cooperar, mientras que los otros dos se comportaron con normalidad.
Los investigadores descubrieron que un juez de IA que supervisaba únicamente la conversación en la mesa no podía distinguir de forma fiable las sesiones con colusión de las sesiones de control.
Los métodos que examinaban los cálculos internos de los modelos obtuvieron resultados considerablemente mejores, con puntuaciones AUROC de entre 0,90 y 1,00 en la tarea de blackjack.
Dos agentes usaron conversaciones en la mesa para compartir conteos de cartas
La prueba de blackjack se diseñó en torno al conteo encubierto de cartas.
Antes de comenzar el juego, los dos agentes coludidos se comunicaron en privado y crearon su propio sistema de señales.
Un agente actuó como contador, siguiendo el conteo acumulado de cartas y codificando información en conversaciones aparentemente normales en la mesa. El segundo actuó como "big player", decodificando esas señales y modificando el tamaño de su apuesta en consecuencia.
Por ejemplo, hacer una pregunta podía representar un conteo negativo, mientras que un comentario entusiasta podía indicar una baraja favorable.
Los dos agentes honestos veían los mismos mensajes públicos, pero desconocían su significado oculto.
Los investigadores ejecutaron 20 zapatos de blackjack diferentes, cada uno compuesto por ocho manos. Los agentes coludidos inventaron un nuevo esquema de codificación para cada zapato.
Cada zapato se probó tanto en una condición de colusión como en una de control, generando un total de 40 ejecuciones.
El juez de IA no pudo identificar la comunicación oculta
El experimento se diseñó para que las señales parecieran una conversación natural en lugar de instrucciones codificadas evidentes.
Eso resultó suficiente para superar la supervisión a nivel de texto.
Un LLM que actuaba como juez marcó como sospechosa una proporción similar de sesiones de colusión y de control, lo que significa que no podía discriminar de forma significativa entre ambas.
El resultado ilustra uno de los problemas de supervisar sistemas autónomos de IA exclusivamente a través de sus salidas visibles. Dos agentes pueden, en teoría, asignar un significado oculto a frases comunes que parecen inofensivas para otro modelo o para un observador humano.
Los métodos basados en activaciones mostraron una distinción mucho más clara.
Las cinco técnicas probadas por los investigadores registraron al menos 0,90 AUROC en el benchmark esteganográfico de blackjack, y la más potente alcanzó 1,00.
AUROC mide la eficacia con la que un sistema separa dos categorías a través de diferentes umbrales de decisión. Una puntuación de 0,5 equivale a una discriminación aleatoria, mientras que 1,0 indica una separación perfecta dentro del conjunto de datos probado.
Los investigadores encontraron señales dentro del modelo en palabras específicas
El estudio también examinó qué ocurría dentro del agente receptor mientras procesaba el mensaje codificado del contador.
En 39 ejemplos emparejados, los investigadores descubrieron que las activaciones internas del big player diferían de las de los agentes honestos, pese a que ambos recibían exactamente el mismo texto.
La diferencia se concentraba alrededor de los tokens que contenían la señal encubierta.
Los investigadores interpretan esto como evidencia preliminar de que un modelo procesa internamente una frase de manera diferente cuando entiende que las palabras contienen un mensaje oculto.
Eso abre la posibilidad de detectar coordinación encubierta mediante el cálculo que tiene lugar dentro de un modelo, incluso cuando su respuesta externa parece normal.
NARCBench prueba la colusión más allá del blackjack
El blackjack fue la prueba estructuralmente más diferente de la investigación, pero no el único experimento.
NARCBench también incluye 50 escenarios principales en 17 áreas y pruebas independientes sobre sabotaje en revisión de código, manipulación bursátil, interferencia en CI/CD, envenenamiento de RAG, manipulación de investigación y encuadre de noticias.
Los investigadores entrenaron primero su sonda de engaño en escenarios de estilo comité y después comprobaron si podía identificar colusión en tareas que nunca había visto anteriormente.
Las cinco técnicas de detección alcanzaron 1,00 AUROC en el benchmark principal.
El rendimiento disminuyó cuando se transfirieron a escenarios estructuralmente distintos. El mejor método alcanzó 0,84 AUROC en las seis categorías de transferencia, frente a un máximo de 1,00 en el experimento de blackjack.
Los investigadores concluyeron que diferentes formas de colusión producen patrones distintos dentro de los modelos, por lo que ninguna técnica de detección fue consistentemente la mejor en todas las tareas.
Los resultados están limitados a un único modelo abierto
Los autores advierten de que los resultados siguen siendo experimentales.
Todas las pruebas utilizaron Qwen3-32B con cuantización de 4 bits. Todavía no se sabe si los mismos métodos de detección funcionarían de forma similar en otras familias de modelos o en sistemas frontier más potentes.
Los investigadores también reconocen que sus sondas podrían estar capturando parcialmente patrones específicos del conjunto de datos en lugar de una representación universal del engaño.
Más importante aún, los métodos requieren acceso a las activaciones internas del modelo. Este tipo de acceso white-box está disponible para organizaciones que ejecutan modelos bajo su propio control, pero generalmente no para usuarios externos de sistemas comerciales cerrados de IA.
Los investigadores tampoco probaron si agentes conscientes de que sus activaciones internas estaban siendo supervisadas podrían adaptar su comportamiento para evitar ser detectados.
Sin embargo, el experimento de blackjack demuestra una diferencia significativa entre supervisar lo que comunican los agentes de IA y supervisar cómo procesan internamente esa comunicación.
En la prueba, los mensajes encubiertos quedaron efectivamente ocultos para otra IA que leía la conversación, pero siguieron siendo altamente detectables cuando los investigadores examinaron las representaciones internas de los modelos.
Comentarios (0)
Aún no hay comentarios. ¡Sé el primero!